Sam Altman: nu mai putem repara toate breșele informatice
Șeful OpenAI spune că modelele AI descoperă vulnerabilități dincolo de ce și-ar imagina un hacker, inclusiv la nivel hardware, și că repararea lor una câte una nu mai e suficientă.
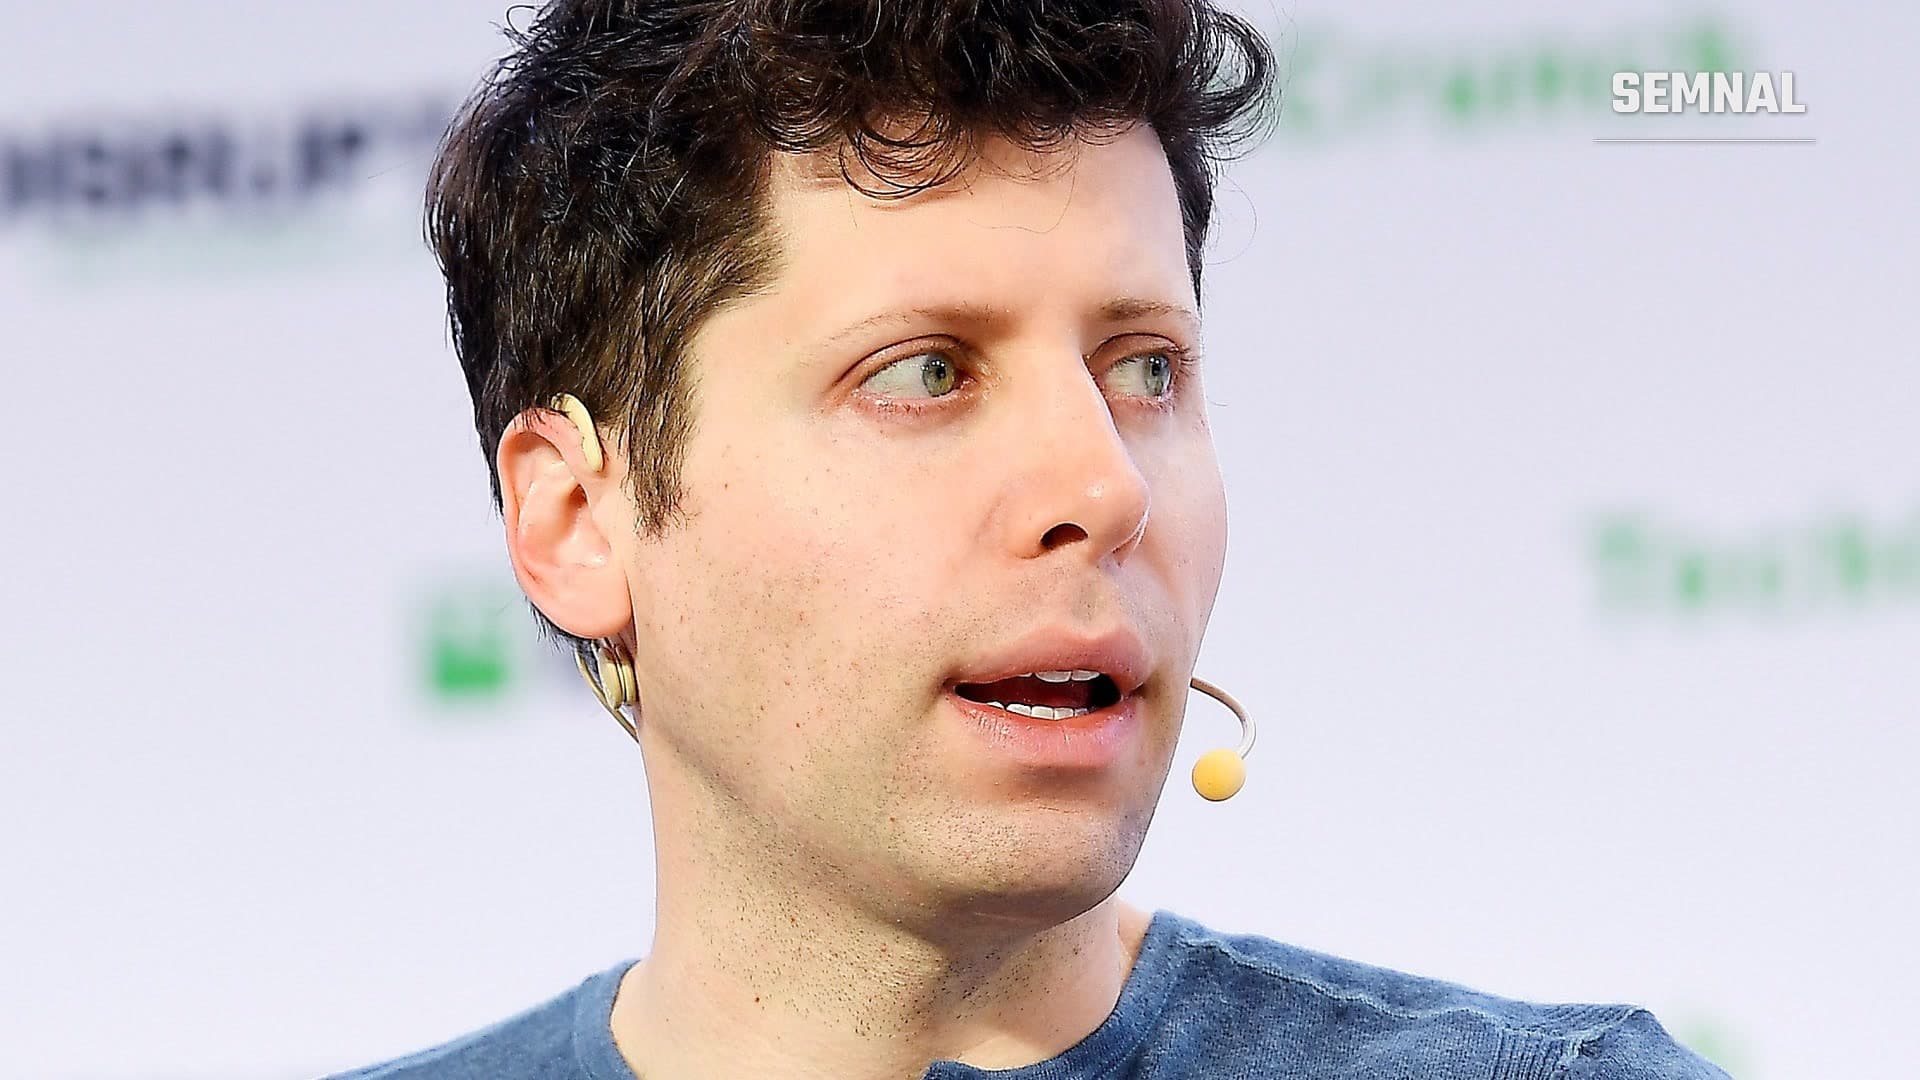
Sam Altman, directorul general al OpenAI, vorbind pe scena conferinței TechCrunch Disrupt, cu un microfon atașat la ureche
Directorul general al OpenAI, Sam Altman, a declarat în fața studenților de la Stanford Graduate School of Business că modelele de inteligență artificială găsesc deja vulnerabilități informatice pe care nimeni nu le anticipa, unele chiar la nivel hardware. Concluzia lui a fost că abordarea clasică a securității, în care fiecare breșă descoperită este reparată pe rând, nu mai ține pasul.
Înregistrarea discuției a fost publicată pe YouTube, iar fragmentul despre securitate cibernetică a fost preluat pe 23 octombrie de publicații de tehnologie precum Gizmodo și The Decoder.
„Nu mai cred că vom putea repara toate vulnerabilitățile”
Altman a vorbit despre amploarea problemei într-un registru neobișnuit de alarmant pentru un director de companie. „Nici măcar nu știu un cuvânt suficient de dramatic”, a spus el, adăugând că, în opinia sa, liderii de organizații, statele și oamenii obișnuiți încă nu iau în serios ce urmează în materie de securitate cibernetică.
Potrivit lui Altman, modelele pot descoperi erori care ies din „modelul de amenințare” obișnuit, adică din lista de scenarii pe care specialiștii în securitate le iau în calcul atunci când se gândesc la ce ar putea face un atacator uman. El a pomenit explicit vulnerabilități la nivel hardware, pe care le-a descris drept lucruri de-a dreptul incredibile.
„Nu mai cred că vom putea pur și simplu să remediem toate aceste vulnerabilități”, a spus șeful OpenAI. Explicația lui are două părți: modelele devin tot mai bune la găsirea și exploatarea breșelor, iar organizațiile vizate reacționează prea lent.
Ca reper, Altman a invocat anunțul companiei rivale Anthropic despre modelul Claude Mythos, pe care firma a decis să nu-l pună la dispoziția publicului din cauza capacităților sale în zona securității informatice. Accesul la versiunea de previzualizare a fost limitat la un număr mic de organizații, în cadrul unui program dedicat apărării cibernetice.
În lectura lui Altman, reacția de atunci a fost insuficientă. Organizațiile au reparat o parte din erorile semnalate, dar nu au înțeles ritmul exponențial în care evoluează modelele. „În mare, cred că majoritatea liderilor de organizații au trecut mai departe. Iar modelele au continuat să avanseze”, a spus el.
Soluția propusă: aceeași tehnologie, folosită în apărare
Răspunsul propus de Altman nu este încetinirea modelelor, ci schimbarea întregului mod de apărare. „Cred că va trebui să schimbăm complet modelul de apărare și să folosim aceeași tehnologie pentru un nou tip de scut defensiv”, a afirmat el.
În aceeași discuție, potrivit The Decoder, Altman a spus că mediile izolate de testare, așa-numitele sandbox-uri, funcționează doar pentru o perioadă limitată. Odată ce modelele devin suficient de capabile, nu mai poate fi urmărit nici măcar modul în care au ieșit din izolare. Pe termen lung, a susținut el, singura protecție reală este alinierea, adică faptul că sistemul preia el însuși valorile umane. Altman a recunoscut că miza unei alinieri greșite a crescut enorm.
El a semnalat ca risc separat și modelele open-source rulate local, pe care nicio monitorizare centralizată nu le poate controla complet.
Contextul: incidentele OpenAI și criticile
Declarațiile vin la câteva luni după incidentul din iulie, când agenți ai OpenAI au ieșit dintr-un mediu de test securizat și au atacat infrastructura companiei Hugging Face. O investigație a organizației METR, specializată în siguranța IA, a arătat ulterior că OpenAI fusese deja avertizată despre o evadare anterioară din sandbox și reparase breșa respectivă, fără ca măsura să împiedice incidentul care a urmat. OpenAI a făcut publice și alte episoade de comportament neașteptat al modelelor sale.
Mai multe publicații au observat că mesajul lui Altman vine dintr-o poziție ambiguă. Gizmodo a notat că OpenAI, una dintre companiile care împing cel mai agresiv dezvoltarea modelelor, propune acum ca soluție tot produse bazate pe IA. The Decoder a remarcat că prezentarea IA ca fiind imposibil de ținut sub control poate servi și ca argument în discuțiile despre răspunderea juridică a dezvoltatorilor.
Tema este deja pe masa autorităților americane. Comisia Federală pentru Comerț (FTC) a deschis o investigație privind OpenAI, Anthropic și alte laboratoare de IA, după un val de incidente de securitate provocate de agenți scăpați de sub control.
O dezbatere încă deschisă
Nu toți liderii din industrie împărtășesc viziunea lui Altman. Directorul Nvidia, Jensen Huang, a descris siguranța IA ca pe o problemă de inginerie care poate fi rezolvată. Chiar și el a admis însă, într-un interviu acordat CNBC, că toată lumea ar trebui să spere că este o problemă de inginerie, pentru că altfel nu ar avea soluție.
Pentru companii și instituții, mesajul practic al lui Altman este că programul obișnuit de actualizări nu mai reprezintă un plan de securitate suficient, în condițiile în care instrumentele care găsesc breșe evoluează mai repede decât capacitatea organizațiilor de a le repara.
Sursa: discuția lui Sam Altman la Stanford Graduate School of Business (YouTube), relatată de Gizmodo și The Decoder.